


Tối ưu vận hành doanh nghiệp bằng Phân tích dữ liệu chuyên sâu (Data-Driven)
Hướng dẫn ứng dụng phân tích dữ liệu chuyên sâu (Data-Driven Analytics) qua 4 cấp độ phân tích bằng ngôn ngữ Python và thư viện Pandas để tối ưu hóa quy trình kinh doanh.
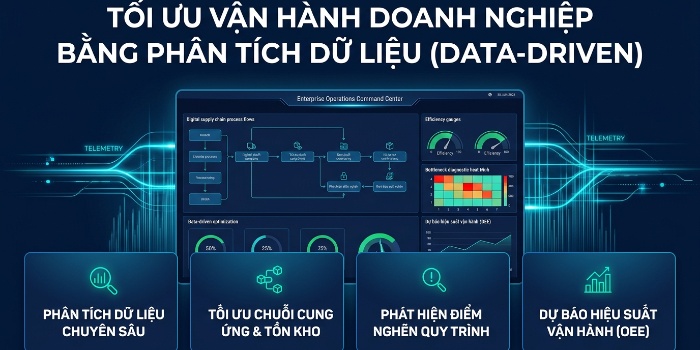
Trong môi trường kinh doanh biến động ngày nay, việc đưa ra quyết định dựa trên cảm tính hoặc kinh nghiệm cá nhân đang dần bộc lộ nhiều rủi ro. Những doanh nghiệp dẫn đầu thị trường hiện nay đều dịch chuyển sang mô hình Quản trị dựa trên dữ liệu (Data-Driven). Bằng cách khai thác sâu các luồng thông tin ẩn giấu sau các hoạt động vận hành, doanh nghiệp có thể dự đoán chính xác nhu cầu thị trường, tối ưu hóa chi phí và phát hiện các cơ hội kinh doanh mới. Bài viết này sẽ phân tích nguyên lý, mô hình 4 cấp độ phân tích chuyên sâu và các công nghệ cốt lõi giúp doanh nghiệp chuyển mình thành một tổ chức chuẩn Data-Driven.
1. Định nghĩa và Công dụng của Phân tích dữ liệu Data-Driven
Phân tích dữ liệu chuyên sâu (Data-Driven Analytics) là phương pháp thu thập, xử lý và áp dụng các mô hình toán học, thống kê lên tập dữ liệu lớn nhằm tìm ra bản chất, xu hướng và các mối quan hệ nguyên nhân - kết quả. Thay vì chỉ dừng lại ở mức làm báo cáo tĩnh, phân tích chuyên sâu sử dụng mã nguồn và thuật toán để bóc tách dữ liệu phục vụ trực tiếp cho các hành động cải tiến vận hành thực tế.
- Dự đoán tỷ lệ rời bỏ của khách hàng (Churn Prediction): Phân tích hành vi, tần suất tương tác và lịch sử mua sắm để nhận diện sớm những khách hàng có nguy cơ rời bỏ dịch vụ, từ đó đưa ra chương trình chăm sóc kịp thời.
- Tối ưu hóa giá bán động (Dynamic Pricing): Tự động điều chỉnh giá sản phẩm/dịch vụ theo thời gian thực dựa trên các biến số về nhu cầu thị trường, lượng tồn kho và hành vi của đối thủ cạnh tranh.
- Quản trị rủi ro chuỗi cung ứng: Phân tích vòng đời sản phẩm và thời gian giao hàng lịch sử của nhà cung ứng để dự báo chính xác các điểm nghẽn hoặc nguy cơ đứt gãy nguồn cung.
2. Nguyên lý hoạt động và Mô hình 4 cấp độ phân tích chuyên sâu
Mô hình 4 cấp độ phân tích dữ liệu
Một quy trình phân tích dữ liệu chuyên sâu tiêu chuẩn được xây dựng tịnh tiến qua 4 cấp độ cốt lõi từ đơn giản đến phức tạp: Phân tích mô tả (Descriptive - Cái gì đã xảy ra), Phân tích chẩn đoán (Diagnostic - Tại sao nó xảy ra), Phân tích dự đoán (Predictive - Cái gì có khả năng xảy ra tiếp theo) và Phân tích kê đơn (Prescriptive - Cần phải hành động thế nào để đạt mục tiêu).
Nguyên lý xử lý dữ liệu bằng mã nguồn mở
Để xử lý các tập dữ liệu lớn vượt quá khả năng của Excel, các nhà phân tích sử dụng nguyên lý lập trình cấu trúc dữ liệu mảng (DataFrames). Dữ liệu được nạp vào bộ nhớ RAM dưới dạng các bảng đa chiều, cho phép thực hiện các phép toán đại số tuyến tính, lọc, gộp và biến đổi hàng triệu bản ghi chỉ trong vài mili-giây.
Hệ sinh thái công nghệ từ các hãng công nghệ lớn
Ngôn ngữ lập trình **Python** là chuẩn mực toàn cầu trong lĩnh vực này nhờ hệ sinh thái thư viện xử lý dữ liệu cực kỳ mạnh mẽ, nổi bật nhất là thư viện **Pandas** chuyên trị dữ liệu bảng, **NumPy** tối ưu tính toán số học và các môi trường làm việc trực quan được hỗ trợ bởi Anaconda hay Google Colab.
3. Bí quyết tổ chức và Tối ưu hiệu năng Phân tích dữ liệu
Khi đối mặt với các tệp dữ liệu vận hành phình to lên đến hàng triệu dòng, mã nguồn phân tích rất dễ rơi vào tình trạng quá tải RAM hoặc chạy mất hàng giờ đồng hồ. Để tối ưu hiệu năng, các kỹ sư dữ liệu cần áp dụng các kỹ thuật cấu trúc sau:
- Sử dụng tính năng Vectorization (Vectơ hóa): Tuyệt đối tránh sử dụng các vòng lặp thủ công (như vòng lặp for/while) để duyệt qua từng dòng dữ liệu trong Pandas. Hãy sử dụng các hàm toán học tích hợp sẵn của Pandas để tính toán đồng thời trên toàn bộ cột (Vectorization), giúp tăng tốc độ xử lý gấp hàng trăm lần.
- Tối ưu hóa định dạng kiểu dữ liệu (Data Types): Mặc định khi nạp dữ liệu, Python thường gán các kiểu dữ liệu tốn bộ nhớ (như float64 hoặc int64). Hãy chủ động ép kiểu (downcast) về float32 hoặc int32 đối với các cột số nhỏ để tiết kiệm đến 50% dung lượng RAM chiếm dụng.
- Ứng dụng Chunking cho tệp dữ liệu siêu lớn: Đối với các tệp CSV hoặc cơ sở dữ liệu nặng hơn dung lượng RAM của máy tính, hãy cấu hình tham số "chunksize" để chia nhỏ dữ liệu thành nhiều phần, đọc và xử lý cuốn chiếu từng phần một.
Lưu ý: Khi làm việc với các bảng dữ liệu có nhiều ô trống hoặc dữ liệu lỗi (Missing Values), hãy xử lý chúng một cách khoa học bằng phương pháp nội suy hoặc loại bỏ chủ động trước khi đưa vào mô hình phân tích để tránh làm sai lệch kết quả thống kê.
4. Tình huống so sánh hiệu quả xử lý dữ liệu lớn
Bảng dưới đây phân tích các chỉ số vận hành thực tế giữa công cụ bảng tính văn phòng thông thường và thư viện lập trình chuyên dụng khi thực hiện gộp và tính toán trên tập dữ liệu giao dịch lớn:
| Tiêu chí đánh giá | Bảng tính văn phòng (Excel) | Thư viện lập trình (Python Pandas) | Điểm cần lưu ý |
|---|---|---|---|
| Giới hạn số lượng dòng hiển thị | Tối đa 1.048.576 dòng (Bị giới hạn cứng) | Không giới hạn (Phụ thuộc vào dung lượng bộ nhớ máy chủ) | Pandas xử lý mượt mà các tập dữ liệu Big Data lên tới hàng chục triệu dòng |
| Thời gian chạy hàm gộp (Groupby) | Chậm, dễ bị treo máy (Not Responding) khi file nặng | Cực nhanh (Dưới 1 giây nhờ tối ưu hóa thuật toán C-level) | Pandas được viết trên nền tảng C giúp tăng tốc độ tính toán tối đa |
5. Những sai lầm, giới hạn hoặc rủi ro cần tránh
- Lỗi thiên vị dữ liệu (Data Bias): Phân tích dữ liệu dựa trên một tập mẫu quá nhỏ hoặc không mang tính đại diện cho toàn bộ khách hàng, dẫn đến việc đưa ra các kết luận sai lệch, gây thiệt hại cho chiến dịch kinh doanh.
- Nhầm lẫn giữa Tương quan và Nhân quả (Correlation vs Causality): Thấy hai chỉ số biến động cùng chiều lập tức kết luận chỉ số này sinh ra chỉ số kia mà bỏ qua các yếu tố nhiễu bên ngoài, dẫn đến việc đưa ra các quyết định "kê đơn" sai lầm.
- Không tự động hóa luồng xử lý (Hard-coding): Viết mã nguồn phân tích phụ thuộc cứng vào cấu trúc tệp của một tháng cụ thể, khiến hệ thống bị lỗi (Crash) khi nạp dữ liệu của tháng tiếp theo vào chạy tự động.
6. Doanh nghiệp nên bắt đầu từ đâu?
Chuyển dịch sang mô hình Data-Driven không phải là câu chuyện một sớm một chiều, doanh nghiệp cần xây dựng văn hóa số đi đôi với năng lực kỹ thuật.
- Bắt đầu bằng việc đặt ra các câu hỏi kinh doanh cụ thể và thực tế (ví dụ: "Tại sao doanh số chi nhánh miền Nam sụt giảm trong quý trước?") thay vì thu thập dữ liệu vô hướng không mục đích.
- Khuyến khích nhân sự ở các phòng ban nghiệp vụ tham gia các khóa học tư duy phân tích cơ bản để biết cách đọc hiểu và phản biện các báo cáo dữ liệu.
- Đội ngũ kỹ thuật nên xây dựng các kho lưu trữ mã nguồn phân tích tập trung (như GitHub hoặc GitLab) để tái sử dụng các đoạn mã làm sạch và biến đổi dữ liệu, giảm thiểu thời gian triển khai cho các dự án sau.
Tài liệu và Nguồn tham khảo từ hãng
Kết luận: Phân tích dữ liệu chuyên sâu theo mô hình Data-Driven là vũ khí tối thượng giúp doanh nghiệp tối ưu hóa mọi ngóc ngách vận hành, thấu hiểu khách hàng sâu sắc và tạo ra lợi thế cạnh tranh bền vững trong nền kinh tế số.
Bạn có thể tra cứu toàn bộ cẩm nang hướng dẫn sử dụng, cấu trúc câu lệnh và các hàm tối ưu dữ liệu nâng cao tại trang tài liệu chính thức của hãng phát triển: Python Pandas Library.
Hải Âu hỗ trợ doanh nghiệp như thế nào?
Hải Âu phối hợp cùng doanh nghiệp làm rõ nhu cầu, phạm vi công việc và điều kiện triển khai để đề xuất phương án phù hợp. Tùy từng bài toán, phạm vi hỗ trợ có thể bao gồm tổ chức nghiệp vụ, phần mềm quản lý, ứng dụng chuyên ngành, dữ liệu và báo cáo BI hoặc dịch vụ chuyên môn liên quan.
- Phần mềm quản lý lõi: ERP, MRP, DMS, Kho và Kế toán
- Ứng dụng chuyên ngành: Số hóa dữ liệu từ điểm tác nghiệp và hiện trường
- Dữ liệu và BI: Hợp nhất dữ liệu và xây dựng báo cáo điều hành thông minh
- Kế toán và Quyết toán: Giải pháp quản lý tài chính và tuân thủ chuẩn mực thuế
- Giải pháp quản trị toàn diện kết hợp đa nền tảng công nghệ
Doanh nghiệp của bạn đang cần tìm giải pháp phù hợp với quy trình vận hành thực tế?
Gửi yêu cầu tư vấn hoặc gọi 0909 597 734 để trao đổi về nhu cầu và phương án phù hợp.
 Gọi điện hoặc Zalo
 Chat tư vấn
 Gửi yêu cầu