


Kiến trúc Dữ liệu hiện đại: Phân biệt Data Warehouse và Data Lakehouse
Hướng dẫn phân biệt cấu trúc, nguyên lý hoạt động của Kho dữ liệu (Data Warehouse) truyền thống và Kiến trúc hồ kho dữ liệu (Data Lakehouse) hiện đại nhằm tối ưu hóa hiệu suất phân tích cho doanh nghiệp.
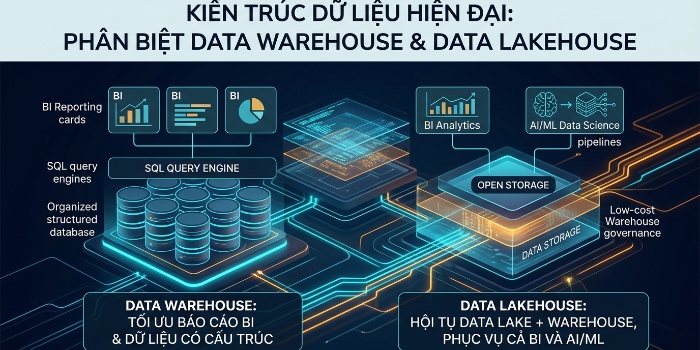
Trong kỷ nguyên số, dữ liệu được ví như "vàng đen" của doanh nghiệp. Tuy nhiên, khai thác được nguồn tài nguyên này hay không phụ thuộc rất lớn vào hạ tầng lưu trữ. Khi khối lượng thông tin phình to cả về quy mô lẫn chủng loại (từ số liệu tài chính đến hình ảnh, video ngầm), mô hình Kho dữ liệu (Data Warehouse) truyền thống bắt đầu bộc lộ những giới hạn. Điều này thúc đẩy sự ra đời của một kiến trúc mang tính đột phá: Data Lakehouse. Bài viết này sẽ giúp bạn hiểu rõ nguyên lý hoạt động và hệ sinh thái công nghệ lưu trữ dữ liệu hiện đại từ các hãng lớn.
1. Định nghĩa và Công dụng của Data Warehouse và Data Lakehouse
Data Warehouse (Kho dữ liệu) là hệ thống lưu trữ tập trung được thiết kế riêng cho việc phân tích và báo cáo các dữ liệu đã có cấu trúc rõ ràng. Trong khi đó, Data Lakehouse (Hồ kho dữ liệu) là kiến trúc thế hệ mới, kết hợp trực tiếp khả năng quản lý dữ liệu chặt chẽ của Warehouse trên nền tảng lưu trữ giá rẻ, linh hoạt của Data Lake (Hồ dữ liệu), cho phép quản lý cả dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc.
- Hệ thống báo cáo quản trị (BI): Sử dụng Data Warehouse để lưu trữ lịch sử giao dịch, dữ liệu nhân sự, tài chính nhằm phục vụ vẽ biểu đồ và phân tích kết quả kinh doanh định kỳ.
- Ứng dụng AI và Học máy chuyên sâu: Sử dụng Data Lakehouse để lưu trữ dữ liệu thô (như file ghi âm cuộc gọi tổng đài, hình ảnh camera) nhằm huấn luyện các mô hình Machine Learning mà không cần chuyển đổi phức tạp.
- Phân tích thời gian thực (Real-time Analytics): Tận dụng luồng dữ liệu liên tục của Lakehouse để phát hiện gian lận thẻ tín dụng hoặc theo dõi hành vi khách hàng trên ứng dụng ngay khi phát sinh.
2. Nguyên lý hoạt động cốt lõi
Quy trình biến đổi dữ liệu (ETL vs ELT)
Data Warehouse vận hành theo quy trình ETL (Extract - Transform - Load): Dữ liệu từ các nguồn phải được trích xuất, làm sạch và định dạng lại đúng cấu trúc rồi mới nạp vào kho. Ngược lại, Data Lakehouse ưu tiên quy trình ELT (Extract - Load - Transform): Dữ liệu thô được đẩy thẳng vào hồ lưu trữ giá rẻ trước, sau đó tầng xử lý sẽ biến đổi dữ liệu tùy theo nhu cầu khai thác cụ thể của kỹ sư.
Tầng lưu trữ mở và Tính chất ACID
Điểm cốt lõi giúp Data Lakehouse vượt trội là việc áp dụng các tầng quản lý dữ liệu mở (như Delta Lake, Apache Iceberg) ngay trên các tệp lưu trữ gốc (như Parquet). Tầng này mang lại tính chất ACID (Atomicity, Consistency, Isolation, Durability) cho hồ dữ liệu, đảm bảo dữ liệu không bị xung đột hoặc lỗi khi có hàng trăm luồng ghi/đọc diễn ra đồng thời.
Hệ sinh thái công nghệ từ các hãng công nghệ lớn
Thị trường chứng kiến sự phân cực rõ rệt về giải pháp: Google Cloud dẫn đầu phân khúc Cloud Data Warehouse với giải pháp Google BigQuery hoạt động theo cơ chế serverless mạnh mẽ; trong khi đó, Databricks là gã khổng lồ tiên phong định nghĩa và phát triển nền tảng Databricks Lakehouse dựa trên công nghệ Apache Spark tối ưu cho dữ liệu lớn.
3. Bí quyết tối ưu hiệu năng cao cho Hệ thống Dữ liệu
Một hệ thống dữ liệu thiết kế sai lầm sẽ ngốn chi phí vận hành khổng lồ và khiến các truy vấn báo cáo mất hàng giờ đồng hồ để phản hồi. Để tối ưu hóa, các kiến trúc sư dữ liệu cần áp dụng các biện pháp sau:
- Thiết lập cơ chế Phân vùng (Partitioning) dữ liệu: Chia nhỏ bảng dữ liệu lớn theo các trường thông tin phổ biến (như Ngày/Tháng/Năm) để khi thực hiện truy vấn, hệ thống chỉ quét qua vùng dữ liệu cần thiết thay vì quét toàn bộ kho.
- Sử dụng Kỹ thuật Cụm (Clustering): Sắp xếp thứ tự lưu trữ vật lý của các hàng dữ liệu dựa trên các cột thường dùng để lọc (như Mã cửa hàng, Mã sản phẩm), giúp đẩy nhanh tốc độ tìm kiếm bản ghi.
- Quản lý chi phí truy vấn chủ động: Cấu hình giới hạn lượng dữ liệu tối đa được quét cho mỗi câu lệnh SQL nhằm tránh việc nhân viên phân tích vô tình chạy các câu lệnh sai quy cách gây lãng phí tài nguyên máy chủ.
Lưu ý: Đối với mô hình lưu trữ đám mây như BigQuery, chi phí được tính dựa trên dung lượng dữ liệu bị quét qua. Tuyệt đối tránh sử dụng câu lệnh "SELECT *" trên các bảng có dung lượng lớn, hãy chỉ gọi chính xác các cột cần phân tích.
4. Tình huống so sánh kiến trúc Warehouse và Lakehouse
Bảng dưới đây phân tích các chỉ số kỹ thuật và khả năng đáp ứng công việc thực tế giữa mô hình Data Warehouse truyền thống và Data Lakehouse hiện đại:
| Tiêu chí đánh giá | Data Warehouse (Ví dụ: BigQuery) | Data Lakehouse (Ví dụ: Databricks) | Điểm cần lưu ý |
|---|---|---|---|
| Loại dữ liệu hỗ trợ | Chỉ hỗ trợ dữ liệu có cấu trúc tốt (Structured) | Hỗ trợ toàn diện (Structured, Unstructured, Semi-structured) | Lakehouse linh hoạt hơn khi doanh nghiệp có nhiều video, hình ảnh |
| Chi phí lưu trữ (Storage Cost) | Trung bình đến Cao (Phụ thuộc vào phí lưu trữ của kho) | Rất thấp (Lưu trữ trên Cloud Object Storage như S3, GCS) | Lakehouse tách biệt hoàn toàn chi phí tính toán và chi phí lưu trữ |
5. Những sai lầm, giới hạn hoặc rủi ro cần tránh
- Biến hồ dữ liệu thành "Đầm lầy dữ liệu" (Data Swamp): Nạp liên tục tất cả các nguồn dữ liệu thô vào hồ của Lakehouse nhưng bỏ qua quy trình quản trị (Data Governance) và gắn thẻ metadata, khiến dữ liệu bị mất dấu và không thể khai thác.
- Thiếu kiểm soát phân quyền dữ liệu (Data Security): Cung cấp quyền truy cập quá rộng rãi vào dữ liệu thô chứa thông tin nhạy cảm của khách hàng (như số điện thoại, số thẻ), vi phạm các quy định pháp lý về bảo mật thông tin.
- Lựa chọn sai kích thước tài nguyên (Compute Size): Cấu hình cụm máy chủ xử lý dữ liệu quá lớn cho các tác vụ nhỏ hoặc quên tắt các cụm máy chủ tự động sau khi hoàn tất tính toán gây lãng phí ngân sách lớn.
6. Doanh nghiệp nên bắt đầu từ đâu?
Xây dựng hạ tầng dữ liệu là một chặng đường dài hạn, doanh nghiệp cần đi từng bước chắc chắn để tránh lãng phí đầu tư công nghệ.
- Đánh giá lại thực trạng dữ liệu: Nếu 90% dữ liệu hiện tại là số liệu vận hành từ ERP, CRM có cấu trúc, hãy bắt đầu bằng một Cloud Data Warehouse (như BigQuery) trước vì tính dễ dùng và triển khai nhanh.
- Đầu tư xây dựng từ điển dữ liệu (Data Dictionary) chuẩn hóa định nghĩa các chỉ số cốt lõi giữa các phòng ban trước khi tiến hành gom dữ liệu về một mối.
- Đào tạo nhân sự kỹ thuật nắm vững kỹ năng viết SQL tối ưu và tư duy quản trị luồng dữ liệu (Data Pipeline) để vận hành hệ thống ổn định lâu dài.
Tài liệu và Nguồn tham khảo từ hãng
Kết luận: Data Warehouse vẫn là lựa chọn xuất sắc cho các bài toán báo cáo tài chính chính xác, nhưng Data Lakehouse mới là tương lai giúp doanh nghiệp khai phóng toàn bộ sức mạnh của trí tuệ nhân tạo và dữ liệu lớn một cách tối ưu chi phí nhất.
Bạn có thể tham khảo tài liệu hướng dẫn vận hành chi tiết và cơ chế tối ưu tại trang chủ của hãng: Google BigQuery Documentation.
Hải Âu hỗ trợ doanh nghiệp như thế nào?
Hải Âu phối hợp cùng doanh nghiệp làm rõ nhu cầu, phạm vi công việc và điều kiện triển khai để đề xuất phương án phù hợp. Tùy từng bài toán, phạm vi hỗ trợ có thể bao gồm tổ chức nghiệp vụ, phần mềm quản lý, ứng dụng chuyên ngành, dữ liệu và báo cáo BI hoặc dịch vụ chuyên môn liên quan.
- Phần mềm quản lý lõi: ERP, MRP, DMS, Kho và Kế toán
- Ứng dụng chuyên ngành: Số hóa dữ liệu từ điểm tác nghiệp và hiện trường
- Dữ liệu và BI: Hợp nhất dữ liệu và xây dựng báo cáo điều hành thông minh
- Kế toán và Quyết toán: Giải pháp quản lý tài chính và tuân thủ chuẩn mực thuế
- Giải pháp quản trị toàn diện kết hợp đa nền tảng công nghệ
Doanh nghiệp của bạn đang cần tìm giải pháp phù hợp với quy trình vận hành thực tế?
Gửi yêu cầu tư vấn hoặc gọi 0909 597 734 để trao đổi về nhu cầu và phương án phù hợp.
 Gọi điện hoặc Zalo
 Chat tư vấn
 Gửi yêu cầu